
Descrivere per includere
Alt-text, intelligenza artificiale e accesso al patrimonio culturale digitale
Diritto all’informazione e atto comunicativo multimodale
La difficoltà di accesso ai contenuti su carta stampata è racchiusa nell'espressione inglese print disabled, coniata da George Kerscher nel 1989 per indicare
una persona che non è in grado di leggere efficacemente i testi stampati a causa di una disabilità visiva, fisica, percettiva, dello sviluppo, cognitiva o dell'apprendimento (traduzione dell’autrice; DAISY Consortium, Print Disabled).
Kerscher stesso estenderà questo ragionamento alla lettura su schermo e dunque alla fruizione dei contenuti digitali.
La vista, dunque, non è il canale d'accesso privilegiato per tutti quando si tratta di fruire contenuti informativi, testuali e non; l'atto comunicativo può avvenire ed essere recepito attraverso modalità e canali sensoriali diversi.
Su questo principio si fonda l’Articolo 21 della Convenzione delle Nazioni Unite sui diritti delle persone con disabilità (UNCRPD 2006) [1]. L’Articolo riconosce alle persone con disabilità il diritto alla libertà di espressione e di opinione e il diritto di accedere all’informazione su base di uguaglianza con gli altri, attraverso qualsiasi forma di comunicazione di loro scelta e che cosa si intenda per «comunicazione» lo chiarisce l’Articolo 2 della stessa Convenzione:
Per «comunicazione» si intendono le lingue, la visualizzazione di testi, il Braille, la comunicazione tattile, i caratteri grandi, i contenuti multimediali accessibili, nonché le modalità, i mezzi e i formati di comunicazione scritti, audio, in linguaggio semplice, letti da una persona e di comunicazione aumentativa e alternativa, comprese le tecnologie dell'informazione e della comunicazione accessibili (evidenziazione dell’autrice; UNCRPD 2006, Art. 2).
La percepibilità del contenuto informativo è il punto di partenza delle Web Content Accessibility Guidelines (WCAG), elaborate dal World Wide Web Consortium (W3C). Il primo dei quattro principi su cui poggiano stabilisce infatti che un contenuto digitale deve anzitutto essere percepibile:
le informazioni e i componenti dell'interfaccia utente devono essere presentabili agli utenti in modi che essi possano percepire (WCAG 2.2, Principio 1).
Un principio che ha assunto valore giuridico con la Direttiva (UE) 2019/882, nota come European Accessibility Act (EAA), volta ad armonizzare i requisiti di accessibilità di prodotti e servizi nel mercato interno dell'Unione Europea [2]. In Italia, questo principio era già stato intercettato pioneristicamente dalla Legge 9 gennaio 2004, n. 4 – Disposizioni per favorire e semplificare l’accesso degli utenti e, in particolare, delle persone con disabilità agli strumenti informatici, nota come “Legge Stanca”, la quale stabilisce gli obblighi per l’accessibilità delle pubbliche amministrazioni.
Convenzione di Faro e digitalizzazione dell’eredità culturale: vera inclusione?
Il digitale offre la possibilità di fruire l’informazione attraverso canali sensoriali diversi facilitando così il diritto alla comunicazione di cui sopra, ma questa possibilità non è automatica. Perché si realizzi, occorre che i contenuti digitali stessi siano progettati tenendo conto dell’accessibilità, garantendo l’interoperabilità con le tecnologie assistive [3] (e adattive), tra cui screen reader, display braille, software di ingrandimento e sintesi vocale.
In ambito MAB (Musei, Archivi, Biblioteche), la digitalizzazione di collezioni e archivi promette di democratizzare l’accesso al patrimonio culturale, consentendo inoltre ai professionisti del settore, e non solo, di consultare materiali e dati altrimenti preclusi, incentivando la ricerca e lo scambio di conoscenze, pratiche e competenze tra istituzioni.
Negli ultimi anni, anche a seguito della pandemia da COVID-19, fondi ingenti sono stati destinati in Italia e in Europa a progetti di digitalizzazione del patrimonio, ampliando le politiche già in atto. In Italia, il Piano nazionale di digitalizzazione del patrimonio culturale (PND) 2022-2026 dell’Istituto centrale per la digitalizzazione del patrimonio culturale risponde esattamente a questa esigenza: promuove la costruzione di un ecosistema digitale capace di offrire nuove opportunità all’intero ecosistema culturale. Il primo obiettivo di cambiamento del Piano è proprio l’ampliamento delle forme di accesso al patrimonio digitale per migliorare l’inclusione culturale.
Queste iniziative si inseriscono nel quadro della Convenzione quadro del Consiglio d'Europa sul valore dell’eredità culturale per la società (STCE no. 199), nota come “Convenzione di Faro” (2005) e ratificata dall’Italia con la Legge 1° ottobre 2020, n. 133. La Convenzione riconosce il diritto di ognuno all’eredità culturale come parte del diritto a partecipare liberamente alla vita culturale, sancito dalla Dichiarazione universale dei diritti umani (1948, Art. 27) e garantito dal Patto internazionale sui diritti economici, sociali e culturali (1966, Art. 15) (Crobe e Schilleci 2024).
Patrimonio culturale visuale e accessibilità
Tuttavia, nonostante gli sforzi normativi, gli investimenti economici e le premesse etiche, l’accessibilità del patrimonio culturale resta un traguardo aperto. Accedere al patrimonio culturale significa infatti, in larga misura, accedere al suo patrimonio visuale: fotografie, riproduzioni di opere, mappe, manoscritti digitalizzati.
Spesso, ancora, collezioni e archivi digitali non consentono alle persone non vedenti o con ipovisione di fruirne – parliamo di circa 30 milioni di persone in Europa secondo le statistiche dell'European Blind Union (EBU) – perché alle immagini che li popolano non sono associate descrizioni alternative (alt-text).
Alt-text e patrimonio culturale digitale
Ma che cos'è, esattamente, una descrizione alternativa? L’alt-text è un testo breve che veicola il significato di un’immagine tenendo conto del contesto in cui questa è inserita.
Ad averne bisogno sono le immagini che svolgono una funzione informativa, diverse dalle cosiddette immagini decorative, che invece non lo richiedono [4]: in una scheda di catalogo online, ad esempio, il filetto ornamentale che separa la sezione “Descrizione” da quella “Bibliografia” non richiede alt-text, mentre la riproduzione dell’opera sì. Allo stesso modo richiedono alt-text le immagini funzionali – icone e pulsanti – per le quali l’alternativa testuale deve descrivere l’azione, non l’aspetto: l’icona a lente d’ingrandimento di un visore ad alta risoluzione va descritta come “Ingrandisci”, non come “Lente d’ingrandimento” [5].
Inoltre, altre due tipologie meritano un’attenzione particolare in ambito MAB. Le immagini complesse, come grafici, piante archeologiche, stratigrafie, tavole comparative, non possono essere risolte con un testo breve: richiederebbero, oltre all’alt-text, una descrizione alternativa estesa che ne restituisca per intero il contenuto informativo [6]. Le immagini di testo – frontespizi, epigrafi, manifesti storici – richiedono invece che l’alternativa riporti le stesse parole presenti nell'immagine [7].
Il fine dell’alt-text è dunque veicolare attraverso il medium testuale un messaggio originariamente affidato al medium visivo. Le persone che non possono vedere un’immagine, ad esempio, possono ascoltare la lettura ad alta voce dell’alternativa testuale tramite sintesi vocale, oppure percepirla a livello tattile attraverso un display braille; le persone che non possono ascoltare un file audio possono visualizzare l’alternativa testuale e leggerla.
La presenza di alt-text rende inoltre i contenuti visuali indicizzabili tramite SEO mentre la sua assenza o la presenza di alt-text non corretti, può penalizzare il contenuto stesso; li rende, allo stesso tempo, leggibili e quindi citabili dai motori di ricerca IA, che utilizzano l'attributo alt come segnale testuale attraverso cui interpretare un'immagine.
Eppure, l'assenza di alt-text resta una delle barriere più frequenti nell’accesso al patrimonio culturale digitale, come testimoniano studi sul tema.
Collezioni digitali e assenza di alt-text: studi ed esempi
Cecilia, Moussouri e Fraser (Cecilia et al. 2023a) sottolineano come la tecnologia per l’implementazione di alt-text esista da decenni, senza aver ancora trovato spazio stabile nelle pratiche quotidiane dei musei e della produzione accademica di settore. Riconoscendo l’importanza di un cambio di prospettiva, gli autori documentano la scelta della rivista Curator: The Museum Journal (Wiley) [8] nel modificare la propria policy editoriale come atto di responsabilità verso un cambiamento dell’intero settore che vada al di là della cultura di conformità normativa. Inoltre, per supportare gli autori nell’implementazione dell’alt-text pubblicano un paper dedicato (Cecilia et al. 2023b).
Mähr e Twente (2025) – il cui progetto verrà analizzato nella sezione: Due progetti dedicati ad alt-text e IA in ambito MAB – documentano invece la lacuna in termini di accessibilità delle immagini all’interno delle collezioni digitali. La loro analisi si concentra su un corpus di oltre 1.700 oggetti digitali della collezione storica Stadt.Geschichte.Basel: nessuno di essi aveva mai ricevuto un alt-text, a dimostrazione di come questo passaggio venga sistematicamente trattato come una priorità secondaria, se non ignorato del tutto.
Anche il British Museum riconosce apertamente, nella propria dichiarazione di accessibilità, che le descrizioni alternative per gli oggetti della collezione online non sono associate direttamente alle immagini, e che alcune di quelle esistenti sono sommarie al punto da risultare non informative [9].
Infine, Van Hyning e Chundury (2026), in una ricerca condotta presso la Library of Congress, osservano come molte collezioni digitalizzate siano prive di descrizioni alternative o trascrizioni che consentano un accesso indipendente agli utenti non vedenti o ipovedenti. Il valore aggiunto di questo studio è la sua impostazione: non si limita a documentare una lacuna, ma attraverso sessioni di design partecipativo con persone con disabilità visiva cerca di rispondere alle seguenti domande di ricerca:
- Quali informazioni desiderano ottenere le persone cieche o ipovedenti sul patrimonio culturale visivo, e quanta descrizione è utile?
- A quali fonti desiderano attingere per ottenere queste descrizioni? Come valutano, partecipanti ciechi e vedenti, i meriti relativi di quattro fonti diverse – le descrizioni generate da strumenti di intelligenza artificiale generalisti, le trascrizioni umane ottenute tramite crowdsourcing, i metadati curatoriali esistenti e le ricerche sul web, comprese quelle per immagini, condotte per ricavare contesto aggiuntivo?
- Quali nuovi modi di interagire con il patrimonio culturale visivo vorrebbero che le biblioteche offrissero?
- Quali sono le loro priorità e i contesti in cui utilizzano il patrimonio culturale visivo?
Il titolo stesso del contributo (Metadata is wonderful, but there’s a coldness to it) riassume l’esito: i metadati curatoriali sono preziosi, ma da soli non restituiscono l’esperienza di un’immagine. I partecipanti chiedono descrizioni che vadano oltre il dato catalografico, includendo dettagli visivi vividi, la presenza umana e il contesto. Da qui la proposta degli autori: strategie descrittive stratificate, capaci di combinare precisione fattuale e ricchezza interpretativa. L’IA, come vedremo, può aiutare in questo processo a patto che resti sotto stretta supervisione umana.
Ma cosa significa davvero utilizzare e implementare l’alt-text? Per capire in che modo possa beneficiarne chi non accede direttamente al contenuto informativo di un’immagine, è necessario fare un passo indietro e osservare cosa accade “dietro le quinte” di una pagina web: più nello specifico, cosa accade quando, navigando con una tecnologia assistiva, incontriamo un’immagine.
Dietro le quinte del contenuto digitale: alt-text, codifica HTML e tecnologie assistive
In maniera molto semplificata, possiamo dire che ogni contenuto digitale percepibile da un utente finale è il risultato di linguaggi che codificano le informazioni rendendole interpretabili dalle componenti software e hardware di un computer o di uno smartphone così come da una tecnologia assistiva. In ambito web, l’HTML è il linguaggio di markup che struttura e descrive i contenuti, definendo la funzione semantica di ogni elemento presente in una pagina. È all’interno di questa codifica che l’alt-text viene tecnicamente implementato.
Le tecnologie assistive, infatti, non sono in grado di ‘vedere’, e quindi veicolare, il contenuto visuale di un’immagine. Per questo è necessario che a ogni immagine venga associato l’attributo HTML alt: la tecnologia assistiva può così leggere il valore testuale inserito e trasformarlo in output vocale, tattile (braille) o in testo ingrandibile, a seconda delle esigenze di ciascuno.
In assenza di alt-text, quando una tecnologia assistiva incontra il tag <img> segnala la presenza dell’immagine, ma il suo contenuto informativo non può essere veicolato. Si crea così una discontinuità informativa rispetto al testo della pagina, ancora più marcata se è presente una didascalia che rimane senza il suo referente visivo per chi non può vedere l’immagine.
Per chi non ha familiarità con l’HTML, l’esempio seguente mostra in concreto dove e come viene inserita la descrizione alternativa all’interno del codice una pagina web:
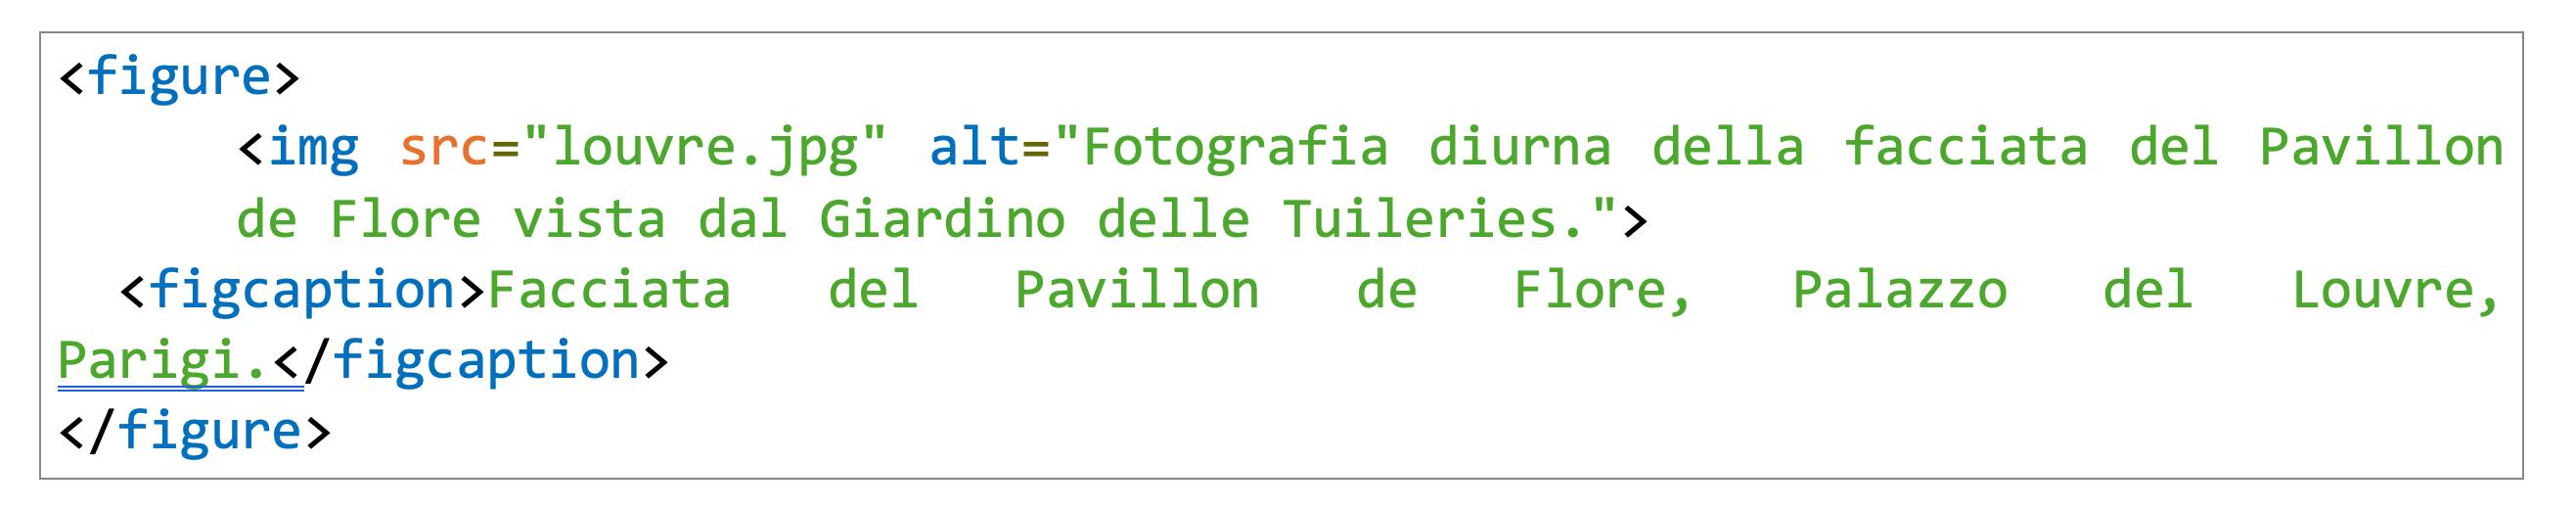
Fig. 1: righe di codice HTML riportanti la descrizione alternativa dell’immagine.
La Figura 2 mostra il risultato visivo delle righe di codice HTML nella pagina web, dove a ogni lettera dell’illustrazione corrisponde un elemento del codice:
- a – figure: il raggruppamento in un unico blocco di immagine e didascalia.
- b – img:
- b1 – src: l’attributo che specifica il percorso o URL del file immagine da caricare.
- b2 – alt: l’attributo che permette di specificare l’alternativa testuale. Compare a schermo, diventando così accessibile a chiunque, solo se il browser fallisce nel caricamento dell’immagine; viene invece sempre letto dalle tecnologie assistive. Nell’illustrazione il testo è mostrato in sovraimpressione a scopo esemplificativo.
- c – figcaption, ovvero la didascalia, visibile a tutti.
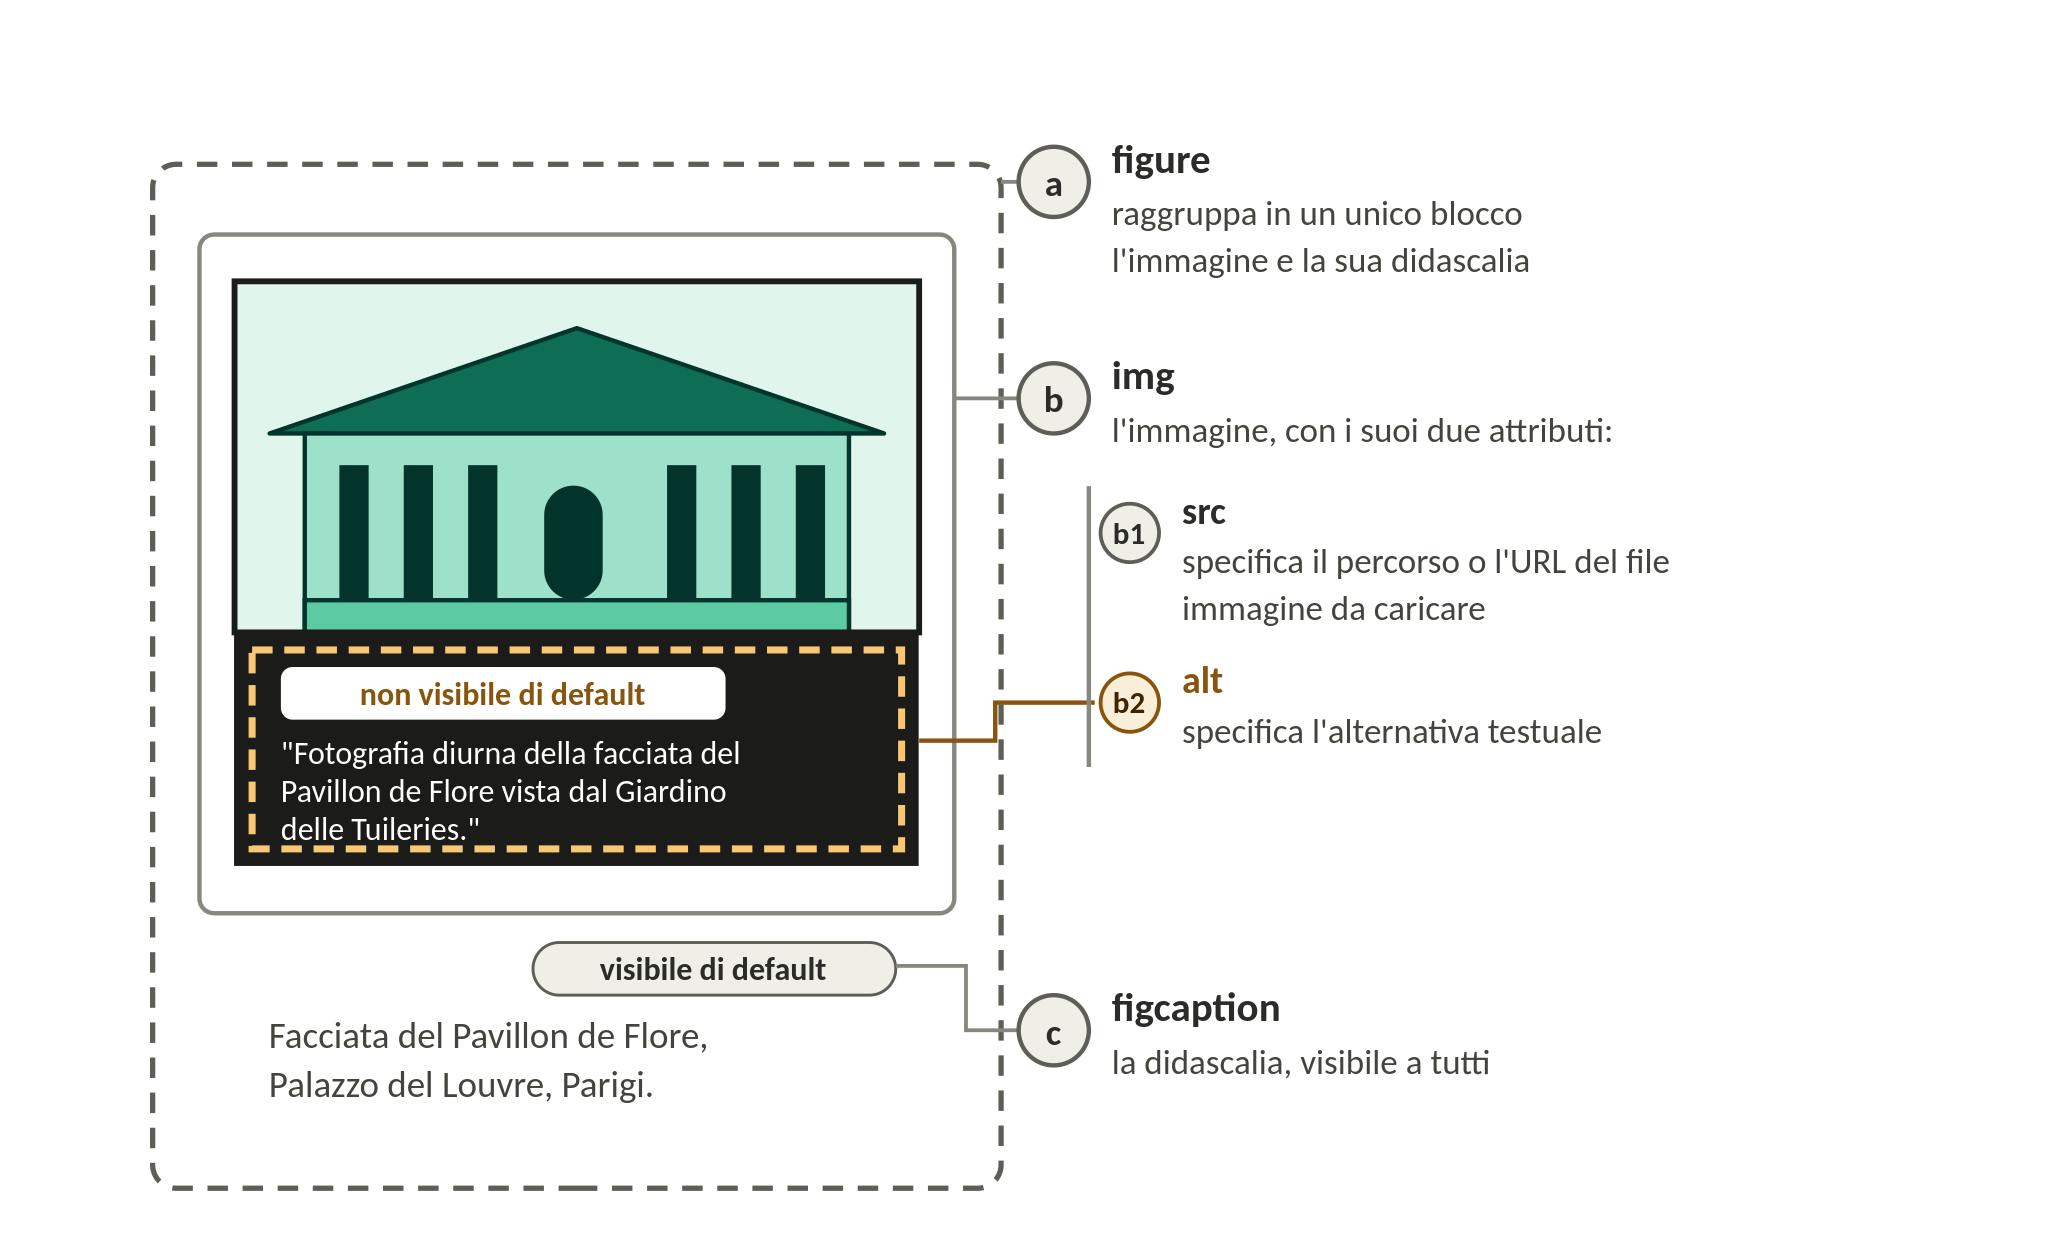
Fig. 2: dal codice HTML alla pagina web (illustrazione prodotta con Claude Opus 5 (Anthropic) su specifica e revisione dell’autrice, agosto 2026).
Alt-text e intelligenza artificiale generativa, un binomio possibile?
La creazione di alt-text è un compito tradizionalmente oneroso: richiede competenze in materia di accessibilità e, allo stesso tempo, una conoscenza specifica del contenuto da descrivere. In ambito museale questo significa padroneggiare la dimensione storica, iconografica e curatoriale dell’oggetto.
Vi si aggiunge un problema di scalabilità. Collezioni digitali di migliaia di item faticano a essere rese accessibili perché l'accessibilità non viene concepita come parte integrante del processo di creazione delle risorse digitali, da svolgere in itinere, ma viene implementata in un secondo momento.
È in particolare su questo ultimo ostacolo che si è innestata l’ipotesi dell’utilizzo dell’IA generativa per la produzione semiautomatica di alt-text. Lo sviluppo di modelli multimodali sempre più performanti ha aperto la strada al loro impiego per questo scopo. Si tratta di sistemi capaci di ricevere in input testo e immagini e di restituire un output testuale che descrive, interpreta o risponde a domande sul contenuto visivo, combinando comprensione linguistica e visiva in un unico sistema.
Tra i modelli utilizzabili per questo scopo figurano, per esempio, Chat-GPT di OpenAI, Gemini di Google, Claude di Anthropic (modelli proprietari) o Mistral Large 3 di Mistral e Qwen3-VL di Alibaba (modelli a pesi aperti), oltre ad applicazioni dedicate come Be My AI di Be My Eyes.
Lo studio delle potenzialità di questi modelli per la creazione di alt-text è tuttora in corso e attraversa ambiti diversi: dagli studi per la produzione semiautomatica di alt-text per le piattaforme di social media (Low et al. 2019), alle ricerche mirate ai contenuti STEM per l’ambito accademico (Buzzi et al. 2024), passando per l’ambito editoriale (Morelli 2025; Risi 2025), fino al patrimonio culturale (van Schalkwyk et al. 2025; Mähr e Twente 2025).
Ogni ambito presenta peculiarità proprie, che si riflettono nel modo in cui l’IA può essere impiegata. Un tratto comune resta però la necessità di un processo semiautomatico, di supervisione umana e di un approccio interdisciplinare che combini competenze in materia di accessibilità con forti conoscenze di dominio.
Due progetti dedicati ad alt-text e IA in ambito MAB
1. Seeing History Unseen: Evaluating Vision-Language Models for WCAG-Compliant Alt-Text in Digital Heritage Collections (Mähr e Twente 2025)
Col progetto Seeing History Unseen: Evaluating Vision-Language Models for WCAG-Compliant Alt-Text in Digital Heritage Collections (2025), Mähr e Twente hanno esplorato l’utilizzo di modelli multimodali per la creazione di alt-text nelle collezioni digitali storiche. Scopo centrale della ricerca è valutare se e come i modelli di IA attuali possano fungere da assistenti all’accessibilità in un flusso di lavoro digitale applicato alla storia. L’approccio adottato è interdisciplinare e combina la sperimentazione computazionale con un’analisi qualitativa fondata sul metodo storiografico.
La ricerca è stata applicata a un dataset eterogeneo, costruito a partire dai dati di Stadt.Geschichte.Basel, e comprende tipologie di item diverse: fotografie storiche, mappe, riproduzioni di artefatti. I modelli multimodali utilizzati coprono sia modelli a pesi aperti: Llama 4 Maverick di Meta e Qwen3 VL 8B Instruct di Alibaba; sia modelli proprietari: Gemini 2.5 Flash Lite di Google e GPT-4o mini di OpenAI.
Lo studio non si esaurisce nell’articolo pubblicato dall’Association for Computers and the Humanities nell’Anthology of Computers and the Humanities (vol. 3): dati, metodologia e pipeline replicabile sono liberamente accessibili nel repository Seeing History Unseen: CHR 2025 Conference Materials.
Nella loro analisi qualitativa dei risultati Mähr e Twente riportano che:
- I modelli multimodali, seppur operativamente utilizzabili, presentano una intrinseca fragilità epistemica col rischio di perpetuare errori fattuali, stereotipi e bias storici.
Per esempio:
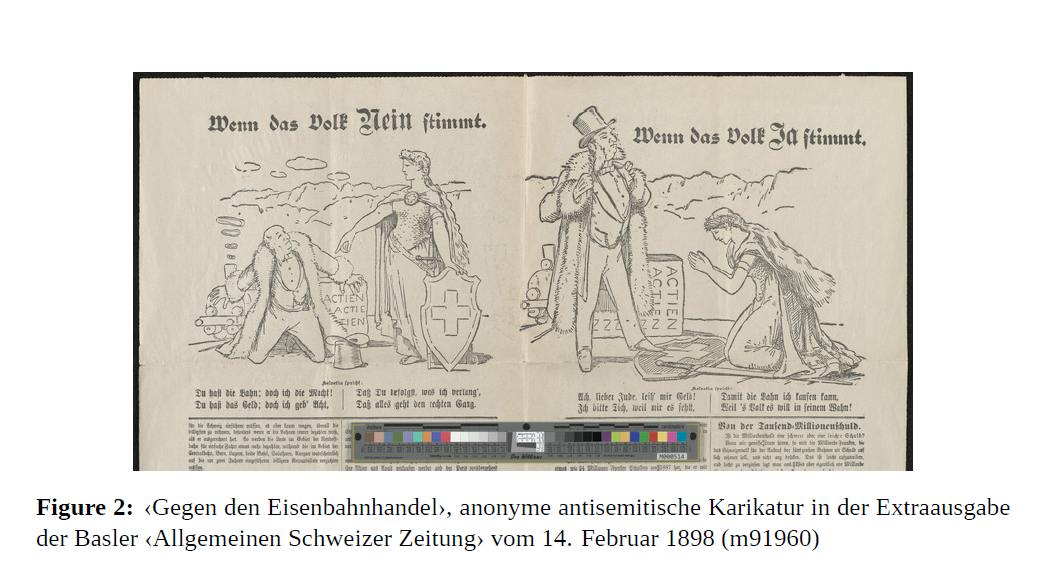
Fig. 3: uno degli item utilizzati come esempio da Mähr e Twente per delineare i risultati dell’analisi qualitativa condotta (Mähr e Twente 2025, 1158).
§ Alt-text (prodotto da Meta Llama 4 Maverick):
Vignetta antisemita sulla nazionalizzazione delle ferrovie 1898. A sinistra: Helvetia in atteggiamento difensivo costringe in ginocchio uno strozzino. A destra: Helvetia inginocchiata chiede denaro a un ricco ebreo. Raffigurazione contrastante del referendum sulla nazionalizzazione delle ferrovie. (traduzione dell’autrice; Mähr e Twente 2025, 1158)
§ Problema riscontrato: come sottolineano gli autori, il testo riproduce acriticamente il termine reichen Juden, ‘ebreo ricco’, stereotipo antisemita probabilmente tratto dai metadati dell’elemento o da dati di addestramento distorti, non di una descrizione neutra del contenuto visivo.
- Non tutti i modelli sono adeguati per ogni categoria di immagine. Un modello che funziona bene su una fotografia può fallire su un diagramma, e viceversa.
- Sebbene i modelli multimodali si dimostrino in grado di creare descrizioni alternative in linea con le linee guida per l’accessibilità, queste descrizioni possono rivelarsi errate dal punto di vista fattuale, discutibili a livello etico, o epistemicamente superficiali ed è quindi necessaria una analisi qualitativa degli output.
In definitiva
Questo studio conferma la concezione dell’IA come assistente per l’accessibilità piuttosto che come autore autonomo. L’output del VLM dovrebbe essere considerato come una prima bozza da sottoporre a revisione umana, non come un prodotto finale (traduzione ed evidenziazione dell’autrice; Mähr e Twente 2025, 1159).
Questo, secondo gli autori, ridefinisce il lavoro dei professionisti del patrimonio digitale: non più autori di alt-text, ma curatori critici di bozze generate dalla macchina. Una transizione che richiede nuove competenze di AI literacy, capaci di riconoscere bias sottili e imprecisioni fattuali anche quando il testo generato rispetta le linee guida in materia di accessibilità (Mähr e Twente 2025).
2. AI-generated alt-text for digital collections (van Schalkwyk et al. 2025)
Il progetto AI-generated alt-text for digital collections di van Schalkwyk et al. (2025) fa parte di un programma nazionale volto a sperimentare un nuovo modello di diffusione dell’IA nel settore culturale e del patrimonio del Regno Unito (Pon et al. 2026). È stato condotto tra novembre 2024 e marzo 2025 e coordinato dal Museo di Storia Naturale di Londra (NHM), con il sostegno del Dipartimento britannico per la Cultura, i Media e lo Sport (DCMS).
Lo scopo è espressamente quello di sviluppare un framework per la creazione di alt-text che combini strumenti di IA e revisione umana, con l'obiettivo di migliorare l’accessibilità digitale e la sensibilità culturale, offrendo un modello replicabile per musei, biblioteche, archivi e gallerie.
Il dataset utilizzato consiste in una selezione di item digitalizzati dal National Museums Liverpool che include dipinti, sculture, reperti di storia naturale e manufatti culturali, selezionati per garantire diversità di tipologie, texture, colori e contesti. È stato inoltre costruito un dataset specializzato, curato da esperti di dominio, di 20 immagini sensibili che ritraggono temi relativi, per esempio, a schiavitù, colonialismo, sessualità, violenza. Questo set consente di testare la capacità dei modelli multimodali di generare descrizioni che rimangano fattuali, rispettose e contestualizzate, ma senza edulcorare le realtà storiche, né ricorrere a linguaggio crudo non necessario. I modelli testati coprono sia soluzioni open source: BLIP-2; sia proprietarie: Claude di Anthropic e GPT di OpenAI.
Un elemento centrale del progetto è la costruzione del prompt, messo a punto attraverso test iterativi e con il contributo dei curatori museali:
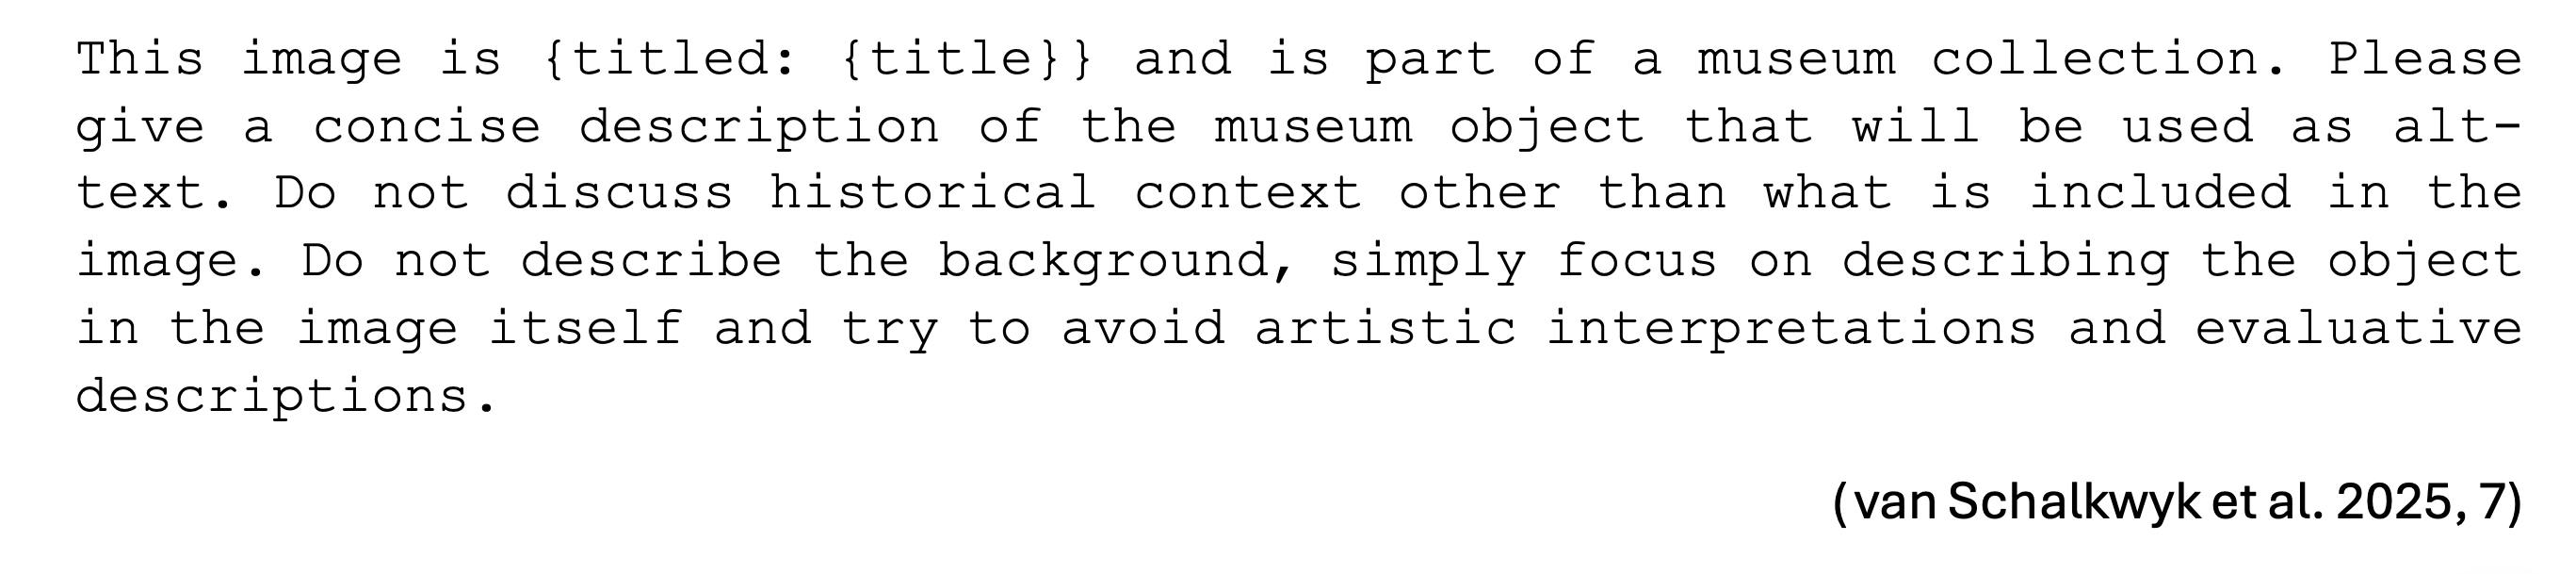
Fig. 4: proposta di prompt per produrre un alt-text dedicato ad un oggetto museale.
Vale la pena notare che questo prompt, applicato indistintamente all'intera collezione, ha mostrato limiti evidenti: per esempio, l’istruzione di non descrivere lo sfondo funziona per una scultura fotografata in museo, ma non per un dipinto in cui lo sfondo è parte dell’opera. Da qui lo sviluppo di prompt differenziati per categoria di oggetto, un segnale di quanto la costruzione delle istruzioni richieda competenza di dominio.
I risultati, oltre a essere valutati da esperti di dominio, sono stati sottoposti a persone con disabilità visiva. Lo studio sull’esperienza utente è stato supportato dalla società di consulenza Accessible by Design attraverso sessioni da remoto, nelle quali i partecipanti hanno valutato ciascun alt-text sia singolarmente sia comparativamente, assegnando un punteggio da 1 a 5 e fornendo commenti qualitativi. Se ne riassumono qui alcuni dati salienti; per un’analisi completa si rimanda al paper.
- Sul piano della forma, i partecipanti hanno espresso una preferenza netta per descrizioni chiare, concise e costruite in modo da collocare all'inizio le informazioni essenziali. La brevità è apprezzata, ma non a scapito del contesto quando questo è rilevante, in particolare per i contenuti storici e artistici; le descrizioni troppo lunghe risultano faticose, anche perché molti screen reader non consentono di riascoltare agevolmente un alt-text.
- Sul piano dei contenuti sensibili, la posizione è stata unanime: l’alt-text deve descrivere la materia in modo fattuale e senza attenuazioni. Omettere o edulcorare, hanno sostenuto i partecipanti, equivarrebbe a una forma di cancellazione, che impedisce di accedere ad aspetti importanti della conoscenza storica.
- Sul piano degli alt-text generati da IA, i partecipanti si sono mostrati in larga parte positivi rispetto al potenziale dell’alt-text generato dall’IA, esprimendo talvolta sorpresa per la qualità delle descrizioni. Lo studio ha però individuato margini di miglioramento su chiarezza, ricchezza contestuale, coerenza delle descrizioni e capacità di adattarsi a esigenze diverse. Le aspettative variano infatti anche in funzione dell’esperienza visiva pregressa: chi ha perso la vista o ha un residuo visivo attribuisce maggiore importanza alle descrizioni cromatiche e ai contrasti. Diversi partecipanti hanno inoltre auspicato un modello più interattivo, in cui l’utente possa richiedere dettagli ulteriori oltre alla descrizione iniziale.
Conclusioni
Digitalizzare il patrimonio culturale non significa automaticamente includere ciascuno nell’accesso a esso, specialmente quando si tratta di patrimonio visuale. Un'immagine priva di descrizione alternativa resta inaccessibile anche quando è liberamente consultabile online.
L'IA generativa mette oggi a disposizione una possibile leva di scala, ma i progetti esaminati convergono su un punto: il modello multimodale produce una bozza, non un testo definitivo. Errori fattuali, stereotipi ereditati dai dati di addestramento e superficialità epistemica richiedono competenza di dominio, sensibilità culturale e il coinvolgimento diretto delle persone con disabilità visiva nella costruzione dell’accessibilità digitale del patrimonio culturale.
L’utilizzo dell’IA per la creazione di alt-text implica un profilo professionale in trasformazione: i professionisti di settore diventano così curatori critici che devono saper combinare le proprie competenze di dominio con competenze in materia di accessibilità e AI literacy. Ovviamente, una condizione preliminare per un vero cambiamento del settore è che l’accessibilità entri nel flusso di lavoro fin dalla progettazione delle risorse digitali. L'accessibilità non si delega a un algoritmo: si costruisce insieme.
Questo contenuto è rilasciato secondo i termini e le condizioni della licenza Creative Commons c.d. “Free Culture” – CC BY- NC-ND .
Diversi termini di titolarità e licenza sono indicati esplicitamente.
[1] La Convenzione delle Nazioni Unite sui diritti delle persone con disabilità (UNCRPD) è entrata in vigore per l'Unione Europea il 22 gennaio 2011, dopo la firma e ratifica da parte di tutti gli Stati membri, i quali si sono così impegnati a garantire i diritti delle persone con disabilità. In Italia, la ratifica è avvenuta con la Legge 3 marzo 2009, n. 18.
[2] In Italia la Direttiva è recepita con il D.Lgs. 82/2022 (Decreto Legislativo 27 maggio 2022, n. 82). Sempre in Italia, nell’ambito dell’accessibilità dei siti web e delle applicazioni mobili della pubblica amministrazione, era già in vigore la Direttiva (UE) 2016/2102, recepita in Italia dal D.Lgs 106/2018 (Decreto Legislativo 10 agosto 2018, n. 106), che aggiorna la Legge 9 gennaio 2004, n. 4 – Disposizioni per favorire e semplificare l'accesso degli utenti e, in particolare, delle persone con disabilità agli strumenti informatici.
[3] Per un approfondimento della nozione di “tecnologia assistiva” e “prodotto assistivo” si rimanda a World Health Organization e United Nations Children’s Fund. Global Report on Assistive Technology. 1st ed. World Health Organization, 2022.
[4] Per una guida dettagliata si rimanda a W3C, Web Accessibility Initiative (WAI), «An Alt Decision Tree», https://www.w3.org/WAI/tutorials/images/decision-tree/.
[5] Per una guida dettagliata sulle immagini funzionali si rimanda a W3C, Web Accessibility Initiative (WAI), «Functional Images», https://www.w3.org/WAI/tutorials/images/functional/.
[6] Per una guida dettagliata sulle immagini complesse si rimanda a W3C, Web Accessibility Initiative (WAI), «Complex Images»,https://www.w3.org/WAI/tutorials/images/complex/.
[7] Per una guida dettagliata sulle immagini di testo si rimanda a W3C, Web Accessibility Initiative (WAI), «Images of Text»,https://www.w3.org/WAI/tutorials/images/textual/.
[8] Rivista dedicata alla museologia e agli studi museali che presenta i punti di vista di esperti e professionisti internazionali all’avanguardia nell’innovazione e nello sviluppo museale, https://onlinelibrary.wiley.com/journal/21516952.
[9] British Museum, Accessibility Statement: «Non-compliance with the accessibility regulations: […] Alternative text for images in object records in Collection online is in the description for the item and not attached to the image itself, which may cause confusion for screen reader users. Some descriptions are well-written, and others are overly basic (e.g., “coin”). This fails WCAG 2.1 success criterion 1.1.1: Non-text content», https://www.britishmuseum.org/accessibility-statement.
Per approfondire
Buzzi, Marina, Giulio Galesi, Barbara Leporini, e Annalisa Nicotera. «Is Generative AI Mature for Alternative Image Descriptions of STEM Content?»: Proceedings of the 20th International Conference on Web Information Systems and Technologies, 2024, 274-281. https://doi.org/10.5220/0012996800003825.
Cecilia, Rafie, Theano Moussouri, e John Fraser. «AltText: An Institutional Tool for Change». Curator: The Museum Journal 66, fasc. 2 (2023a): 225-231. https://doi.org/10.1111/cura.12551.
Cecilia, Rafie, Theano Moussouri, e John Fraser. «Accessible Digital Images: AltText Guidelines for Authors and Museum Professionals». Curator: The Museum Journal 66, fasc. 4 (2023b): 537-546. https://doi.org/10.1111/cura.12577.
Convenzione quadro del Consiglio d'Europa sul valore del patrimonio culturale per la società (STCE no. 199), https://www.coe.int/it/web/conventions/full-list?module=treaty-detail&treatynum=199.
Crobe, S., e F. Schilleci. La Convenzione di Faro come diritto al patrimonio culturale : comunità di pratiche e cura: prospettive per il ridisegno dei territori. IT, 2024. https://iris.unipa.it/handle/10447/641575.
DAISY Consortium. «Print Disabled». In Glossary. https://daisy.org/info-help/glossary/.
Low, Christina, Emma McCamey, Cole Gleason, Patrick Carrington, Jeffrey P. Bigham, e Amy Pavel. «Twitter A11y: A Browser Extension to Describe Images». Proceedings of the 21st International ACM SIGACCESS Conference on Computers and Accessibility, 24 ottobre 2019, 551-553. https://doi.org/10.1145/3308561.3354629.
Mähr, Moritz, e Moritz Twente. «Seeing History Unseen: Evaluating Vision-Language Models for WCAG-Compliant Alt-Text in Digital Heritage Collections». In Anthology of Computers and the Humanities, a cura di Taylor Arnold, Margherita Fantoli, e Ruben Ros. Association for Computers and the Humanities, 2025. https://doi.org/10.63744/njQVYcLndSPE.
Morelli, Caterina. «Enhancing Accessibility in Publishing: Leveraging GAI for Effective Alt-Text Solutions». In Technology for Inclusion and Participation for All: Recent Achievements and Future Directions, a cura di Katerina Mavrou e Pedro Encarnação. Springer Nature Switzerland, 2025. https://doi.org/10.1007/978-3-032-01632-4_48.
Kleege, Georgina. «Blindness and Visual Culture: An Eyewitness Account». Journal of Visual Culture 4, fasc. 2 (2005): 179-190. https://doi.org/10.1177/1470412905054672.
Poon, Sanson T. S., Arianna Salili-James, Chris Addis, et al. «Scaling AI Across the UK Culture and Heritage Sector: The NHM-DCMS AI Pilot Programme». Biodiversity Information Science and Standards 10 (gennaio 2026): e182096. https://doi.org/10.3897/biss.10.182096.
RISD Museum. «Alt Text and Accessibility | RISD Museum». 31 maggio 2022. https://risdmuseum.org/art-design/projects-publications/articles/alt-text-and-accessibility.
Risi, Milena. «Accessible Images: AI-Generated Alt Text in Educational Publishing: Key criteria for creating alt text to enhance accessibility in educational publishing». Logos 36, fasc. 1 (2025): 50-69. https://doi.org/10.1163/18784712-20240039.
van Schalkwyk, Hester, Chris Addis, Sanson Poon, Arianna Salili-James, et al. «DCMS x NHM AI Pilot Project – NML – AI-Assisted Alt-Text Creation for Heritage Collections». Natural History Museum, 2025. Zenodo. https://doi.org/10.5281/zenodo.16883819.
Van Hyning, Victoria, e Pramod Chundury. «“Metadata is wonderful, but there’s a coldness to it”: exploring the visual accessibility of cultural heritage through participatory design». Information Research an international electronic journal31, fasc. iConf (2026): 438-447. https://doi.org/10.47989/ir31iConf64240.